
如果你对科学实验的印象还停留在“科研人员守着仪器调参数、盯着屏幕等数据”,那可能需要更新一下认知了。在北京,人工智能正在深度介入科学研究:它不仅能秒级解析实验数据,还能自主调度实验参数;不仅能预测蛋白质结构,还试图让生命从分子到器官“动”起来。
让AI读懂生命的“动态电影”
让AI学会读懂生命从分子到器官的“动态电影”,这一幕正发生在由清华大学膜生物学全国重点实验室与清华大学生命科学人工智能研究中心共同建设的“跨尺度生物结构世界模型及应用”中。
“我们的‘独门绝技’,是通过理解生命系统的运行机制,把不同尺度的生物结构和功能信息连接起来,建立一个能够模拟生命世界运行的世界模型。”清华大学生命科学学院副教授张强锋介绍。他打了个更形象的比方:“我们可以把单个分子的结构比作一个零件的图纸,而我们希望进一步理解这些零件在真实细胞中处于什么位置和状态,如何组装、如何协作运转,以及这些动态变化怎样影响整个系统。”这正是“跨尺度生物结构世界模型及应用”要解决的核心问题。
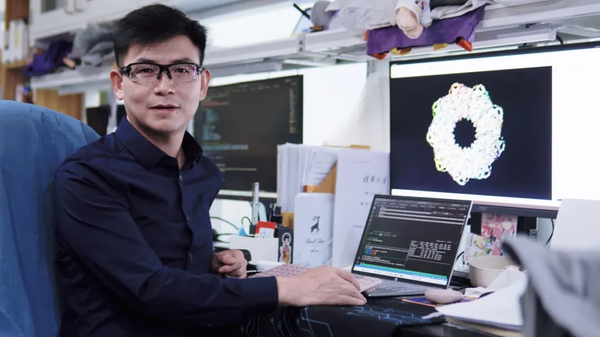
过去,AI在生命科学中的应用多是看见什么学什么,从数据中归纳规律、给出预测,但并不真正理解背后的机制。张强锋团队的思路是:让AI去学习生命系统运转的内在逻辑,这样构建出的“世界模型”,不再只是一个预测工具,而是一个可以推演生命过程的数字系统。它不仅知道生命“是什么样”,更能在一定程度上回答“为什么会这样”和“改变它会怎样”。
“很多疾病过程涉及多个尺度:一个分子的结构或相互作用发生变化,可能改变细胞内部的协作网络,进而影响细胞状态以及组织功能。”张强锋进一步解释,“建立跨尺度动态框架,就是希望把这条联系逐步解释清楚,既描述某一时刻的状态,也推演系统在被扰动后如何变化,这也是世界模型的核心内涵所在。这一功能的实现,让我们有机会在开展实验之前提出更有针对性的假设。”
这一能力将带来两个层面的重要改变:在科学研究层面,AI将从“辅助解析结构”的工具,升级为“解释生命机制、推演干预结果”的科研伙伴。科学家可以在数字世界中对“扰动某个分子、干预某条通路会发生什么”进行先行推演,比较不同干预可能产生的影响,把宝贵的实验资源集中到最有希望的假说上。在生物医药创新层面,基于机制理解的跨尺度动态建模,有望将药物对分子靶点的作用与细胞响应、组织功能变化联系起来,帮助研究者理解一次分子层面的干预如何影响更大尺度的生命过程。这将为发现以往被忽略的药物靶点、评估候选药物的潜在疗效和不良影响提供依据,使药物设计与筛选更有针对性,从而加快从科学发现到药物创新的进程。
效率的提升,已经有迹可循。传统流程往往需要对大量候选逐一开展实验,而AI可以先综合结构、互作和细胞响应信息,优先选出最值得验证的候选,再根据实验结果更新预测。效率提升主要来自减少低价值实验和反复试错。以SCA3(脊髓小脑性共济失调3型)为例,利用自研的AI模型结合实验迭代,极大加速了前期的药物研发周期——传统方式往往需要2至3年,张强锋团队在1年左右就拿到了临床前候选药物(PCC)。
这项工作的关键是实验研究与AI建模紧密协同:膜生物学全国重点实验室的优势在于提出重要的生物学问题、获取结构和功能实验数据、验证模型预测,生命科学人工智能研究中心则侧重多模态数据融合、算法研发和跨尺度建模,双方共同形成预测与验证的闭环。从现有研究基础看,团队在结构识别与建模、分子互作分析以及单细胞和空间组学分析等方面已有积累,下一步重点是将这些能力衔接起来,在代表性生物学场景中验证跨尺度模型的有效性。
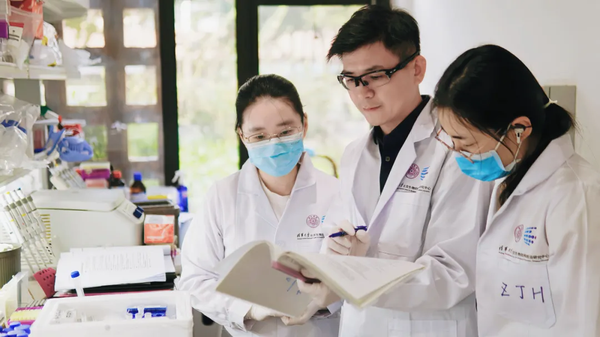
挑战仍在,但路径已经清晰。“最大的挑战是把不同尺度的数据真正对应起来:分子结构、细胞状态和组织空间信息在分辨率、采集方式和时间尺度上都有差异,原位结构的识别与标注也很困难。同时,模型不仅要在已有数据上表现良好,还要能可靠地预测新的扰动,并给出可验证的机制解释。”张强锋说。
团队计划从数据积累较丰富和实验验证基础体系较成熟的代表性场景入手,逐步连接分子互作、细胞响应和组织变化,通过“预测—实验验证—模型校准”不断完善,再扩展到更复杂的生物系统和药物研发全流程。从一张“照片”到一部“电影”,AI正在学会读懂生命的动态剧本。这场跨尺度的探索,也正在加速。预计该项目可将复杂药物研发周期缩短60%以上,为从源头创新到临床转化的全链条提供核心驱动力,助力我国在生物医药“卡脖子”技术上实现突破。
给“超级放大镜”装上“AI操作系统”
同样的AI4S浪潮,在北京怀柔科学城呈现出另一种形态。
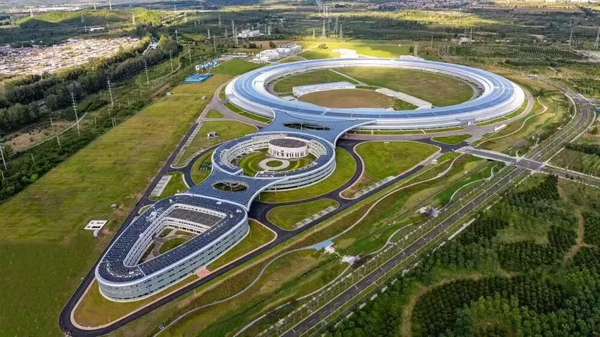
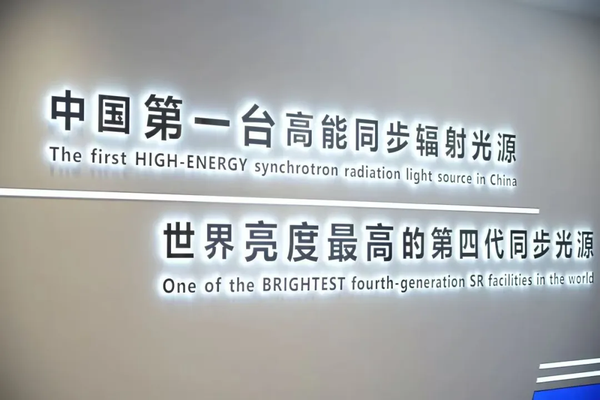
位于怀柔科学城的高能同步辐射光源(HEPS)是世界上亮度最高的第四代同步辐射光源之一,这个大装置就像一台超级“显微镜”,能帮助科学家看清物质内部的微观结构。HEPS每年可产生约数百PB科学数据。这是什么概念?1PB约等于100万GB。所以面临着数据规模大、通量高、模态多、分析高度依赖专家经验等核心难题。
由中国科学院高能物理研究所建设的先进光源AI4S创新平台专为攻克这些难题而来。“这个项目的典型性首先不是一个单点算法或单一软件,而是面向先进光源建设了一套贯通科学数据、算力、模型、智能体和实验控制的‘AI操作系统’,推动同步辐射实验从‘人工操作、事后分析’向‘数据驱动、智能解析、自主调控’的新型范式转变。”中国科学院高能物理研究所特聘研究员张正德介绍。
先进光源AI4S创新平台构建了“数据底座—算力设施—智慧大脑—用户平台—智能应用”五层递进体系。简单说,就是从数据怎么存、怎么算,到AI怎么分析、怎么决策,再到实验怎么调控,形成一条完整链条。团队自主研制了DOMAS数据管理系统、DAISY科学分析系统、DORA数据智能体和IPSBrain智慧光源大脑AI解析系统,融合领域模型、知识库、技能库与多智能体协作框架,贯通数据采集、管理、分析、融合、知识发现和实验调控全过程,推动科学数据由“可保存”向“可理解、可追溯、可复用、可训练”转变。
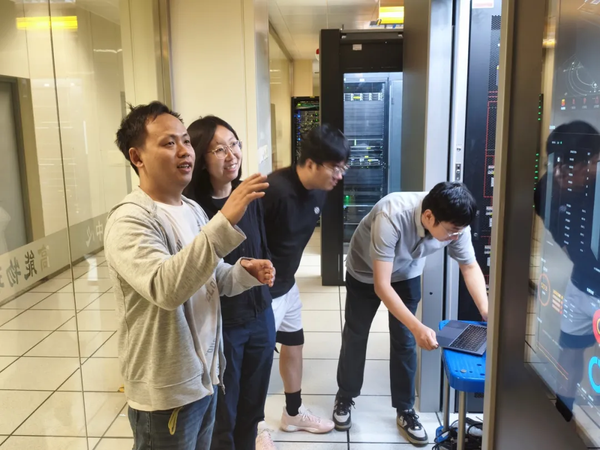
目前,平台已经从基础软件建设进入真实科研场景应用阶段。效果有多明显?举几个案例。X射线吸收谱分析从数小时缩短到秒级,准确率超过95%,效率提升上万倍。衍射精修智能体达到人类专家水平,效率提升5倍。实验参数优化从40分钟压到8分钟。
这意味着,AI不再只是实验结束后的“分析工具”,而是真正进入了实验环节,参与调度、判断和优化。目前,平台已形成PB级AI就绪数据资源,访问量超过3万次,服务40余家单位,相关技术还在中国散裂中子源、硬X射线自由电子激光、上海光源、合肥光源等装置推广应用。换句话说,这套方案不是“一装置一方案”,而是具有跨装置复制能力的建设模式。
张正德说,下一步,团队将建设10PB级AI就绪科学数据库,推动科学智能体从原型验证走向规模化实用,力争到2030年支撑3至5项重大基础物理或交叉学科突破。
科学智能的“北京范儿”
北京汇聚了国家实验室、科研院所、高水平大学和重大科技基础设施,能够持续产生高价值科学问题、专业数据和真实应用场景;同时,北京在人工智能算法、基础模型、算力平台和高端人才方面基础雄厚。这种“科学问题”与“AI能力”的双向奔赴,让北京不仅成为科学智能的策源地,更成为创新范式的试验场。
典型案例
典型案例
张强锋团队期待,通过开源工具包、专用数据集和API接口的开放,让更多学术界与创新药企用上跨尺度生物结构世界模型,推动生命科学源头创新。张正德则期待北京能够率先形成从科学问题、数据资源、模型工具到实验验证和成果转化的完整生态,建设具有国际影响力的科学智能创新高地。
从秒级解析X射线吸收谱,到跨尺度动态生成生物结构,AI正在北京的科学舞台上,从“辅助工具”变成“科研伙伴”。它改变的不仅是一个个实验环节,更是科学家提出问题、验证假设、发现规律的方式!
科学智能北京范儿:
人工智能从辅助工具跃升为推演与发现的“智能共研者”,科研范式正在发生变革。作为人工智能赋能科学研究的策源地,北京率先发布了首批16个典型案例。“科学智能北京范儿”栏目将走进这些案例,生动呈现AI参与的科学问题、改变的研究环节和取得的实际突破。邀您一起,见证智能时代科研变革的北京答案。