
新药研发为什么这么难?一个关键原因是可成药的小分子化学空间大到超乎想象,而很多复杂疾病又找不到明确靶点。AI能改变这个局面吗?北京市首批人工智能赋能科学研究典型案例中,北京大学药学院与北京望石智慧科技有限公司共建的“AI赋能新药创制平台”给出了一个答案;而北京中关村学院与中关村人工智能研究院联合建设的“FlexRibbon”平台,则在蛋白质药物自主设计这条赛道上补上了重要的拼图。
AI赋能新药创制平台 让“撞大运”变成“算得准”
传统新药研发,像是10⁶⁰个分子的化学空间里“大海捞针”,靠专家经验、高通量实验和反复试错,平均耗时10年以上、投入超26亿美元,临床成功率却不足10%。更棘手的是,衰老、代谢病、自身免疫病等复杂疾病,往往没有明确的单一靶点,传统“锁定靶点→筛选配体→优化活性”的研发路径越走越窄。而AI赋能的新药创制平台,正在从底层重塑这一范式。
(北京大学智慧药物平台)
“AI赋能新药创制平台将灵素药效预测、靶点重定向、蛋白质从头折叠基座模型、药物研发智能体四件事串成一条‘流水线’将整个早研链条重新排了一遍,整体我们可以将3到5年的试错周期压到12到18个月。”北京大学博雅教授、教育部长江学者谢正伟介绍。在这个平台上,灵素系统解决“药有没有效”,靶点重定向解决“打谁、能不能老靶新用”,蛋白从头折叠基座解决“分子和蛋白界面怎么长出来”,药物研发智能体则把整个研发流水线调度起来。
AI赋能新药创制平台要做的事,不是把所有钥匙都插进锁里试,而是先把“这把钥匙会不会让门后的房间恢复正常”算出来。用谢正伟的话说,就是在10⁶⁰个分子里“先画地图,再定点挖宝”。比如,在灵素系统里,做NASH(非酒精性脂肪性肝炎)、肥胖、高尿酸这类复杂病时,不再一上来就买整个小分子库做湿实验,而是用基因指纹先排优先级。原来做一个标记基因的高通量筛选要花掉几百万资金,做大量动物实验。现在候选池能从“百万级实体分子”精准缩减到“十级、百级值得验证的分子”。如果把早期发现阶段的几个关键环节放在一起看,变化更直观,利用这个平台,可以将新药早期研发到PCC(临床前候选化合物)的周期大致压缩到原来的三分之一到四分之一;早期合成与验证成本可降约80%。
谢正伟总结说:AI提升效率的本质不是“算得快”,而是“少合成、少动物实验、少走死路、少等人脑复盘”,把3到5年里的盲目试错换成可解释、可回溯、可复用的决策。
现在这个平台已经面向医药研发机构开放药物智能设计工。云南白药接入灵素系统,结合基因指纹药效预测、衰老与代谢和免疫等场景,打造创新研发的方法学底座。北京亿药科技有限公司与一家药企成立合资公司,把灵素系统作为核心引擎注入,目标是“一年半内完成一个化合物的IND申报”。对亿药科技来说,这等于用一家合资公司把原本买不起也养不起的“AI早研大脑”嵌进了自己的创新药业务里,实现从仿制药向创新药转型。
北京大学博雅教授、国家杰出青年科学基金获得者刘涛则从另一个角度阐述了平台的产业价值。他以与北京泰德制药的合作为例:双方正在将AI真正嵌入抗体和ADC等创新药的研发流程。通过AI辅助抗体设计、亲和力和成药性优化,以及ADC(抗体药物偶联物)中抗体、linker(连接器)、payload(有效载荷)和偶联策略等多参数协同设计,减少低价值候选进入实验环节。更重要的是,实验结果还会持续反馈给AI,用于下一轮候选设计和优化,逐步形成“设计—实验—学习—再设计”的研发闭环。他说:“我们希望AI带来的不仅是某一个计算环节提速,而是帮助企业降低试错成本、缩短研发周期,并逐步建立自主的智能化药物研发能力。”
在谢正伟看来,新药创制不是发论文就结束的事,中间有三道高校单独跨不过去的坎:数据闭环不够、工程化不够、转化动力不够。北京大学药学院和望石智慧联手,高校把“为什么有效”讲清楚,企业把“怎么变成药、怎么跑通研发流水线”做出来,这个组合好比是科学发动机加上了产业转化器。
现在,摆在AI赋能新药创制平台面前的挑战已经不只是“AI能不能设计分子”,而是如何获得高质量实验数据,以及如何让计算设计和实验验证真正形成闭环。AI赋能新药创制平台将持续推动AI从一个“设计工具”,进一步发展为能够根据实验结果持续学习和优化研发策略的“科研伙伴”,实现新药研发从AI辅助设计向AI驱动研发的升级。
FlexRibbon 让蛋白质药物设计从“盲筛”变成“精准选角”
如果说AI赋能新药创制平台是在小分子化学空间里“画地图、定点挖宝”,那么由北京中关村学院、中关村人工智能研究院共同建设的面向柔性生物界面的蛋白质药物智能设计平台FlexRibbon,则是在蛋白质的动态构象世界里“拍电影、精准选角”。
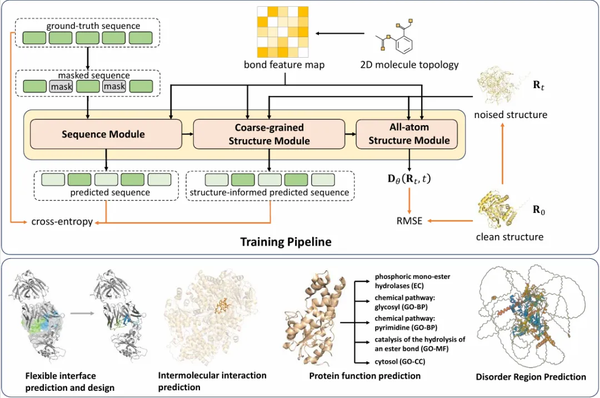
(FlexRibbon 蛋白质结构基座模型整体框架)
传统蛋白质研发大多关注蛋白静态晶体结构,难以刻画蛋白结合界面动态构象变化,而柔性区域恰恰决定蛋白药物与靶点的结合能力。现有主流蛋白模型高度依赖多序列比对信息,在突变丰富、柔性突出的抗体环区等场景预测精度不足;研发模式依靠大规模文库筛选,实验周期漫长、试错成本高昂,候选分子筛选空间受限。
北京中关村学院与中关村人工智能研究院一体两院融合发展,秉持“极基础、极应用、极交叉”理念,联合31所双一流高校开展协同创新,设立AI+科学技术学部,深耕生命科学智能研发,聚焦蛋白质药物、计算生物等赛道开展原创算法与科研平台攻关。FlexRibbon正是这一布局下的代表性成果。
项目构建序列与全原子结构联合预训练框架,重点捕捉蛋白柔性界面动态特征,补齐传统模型短板。平台实现蛋白质柔性相互作用预测、全新蛋白分子从头设计、功能评估一体化运行,支持抗体、纳米抗体等多种蛋白质药物研发,在十余项生物预测任务上取得性能突破。平台打通AI建模与实验验证链路,压缩蛋白质药物研发周期、减少盲筛实验投入,形成AI驱动蛋白质药物自主设计新型范式。
典型案例
典型案例
当AI成为“科研伙伴”,新药研发的范式正在改写。未来十年,AI制药未必是谁分子库更大,而是谁更会把实验数据变成可复用知识:算得准、学得快、闭环稳,能让候选分子更快走到临床,让患者更早用到更靠谱的新药。
科学智能北京范儿:
人工智能从辅助工具跃升为推演与发现的“智能共研者”,科研范式正在发生变革。作为人工智能赋能科学研究的策源地,北京率先发布了首批16个典型案例。“科学智能北京范儿”栏目将走进这些案例,生动呈现AI参与的科学问题、改变的研究环节和取得的实际突破。邀您一起,见证智能时代科研变革的北京答案。