
在北京首批16个人工智能赋能科学研究典型案例中,磐石科学基础大模型、DPA大原子模型、OpenComplex全原子微观生命模型(以下简称:磐石、DPA、OpenComplex)把AI从“会聊天”推向“会干活”,科学智能的“超能力”正走进天文望远镜、材料计算和生物分子里,改写从观测、计算到药物发现的科研范式。
磐石:把大模型变成理科生
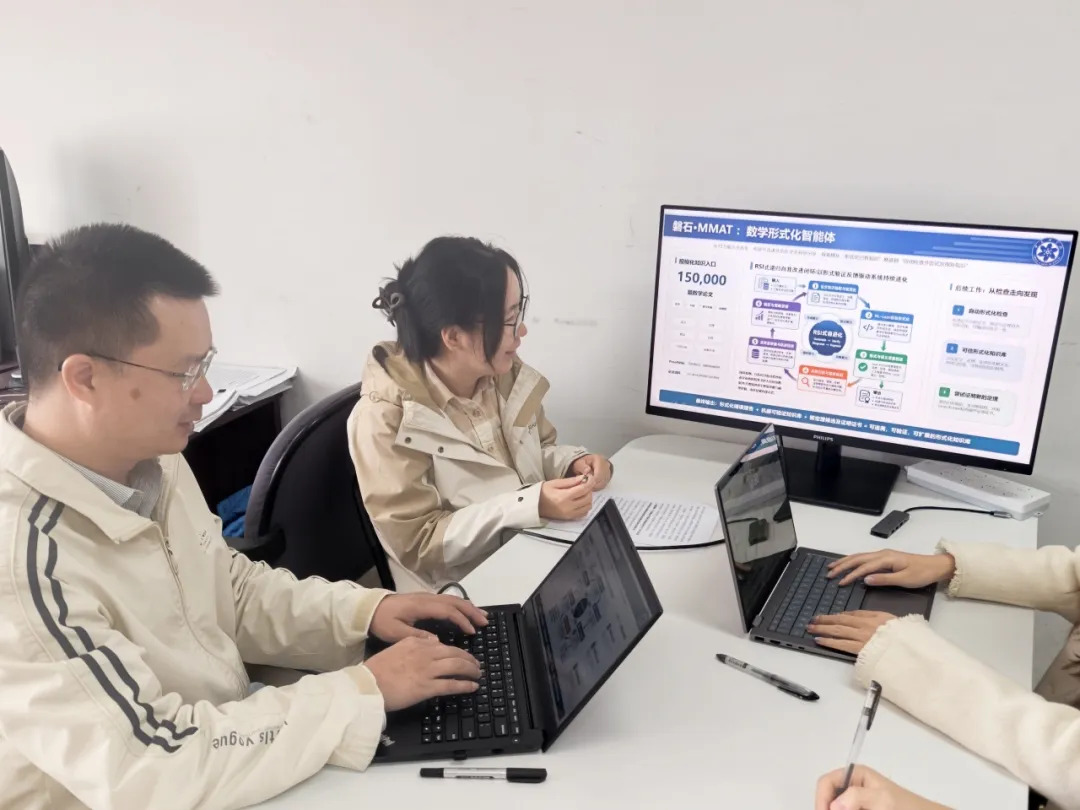
“日常使用的通用大模型科学能力偏弱,是一个偏文科生的模型,我们想把模型变成理科生,这就是磐石的特点。”中国科学院自动化所研究员李林静在采访中打了个生动比方。磐石由中国科学院自动化研究所、中科闻歌等单位共同建设。它的关键词是“通专融合”:既保留通用模型的基础能力,又补上科学研究需要的机理约束和学科能力。
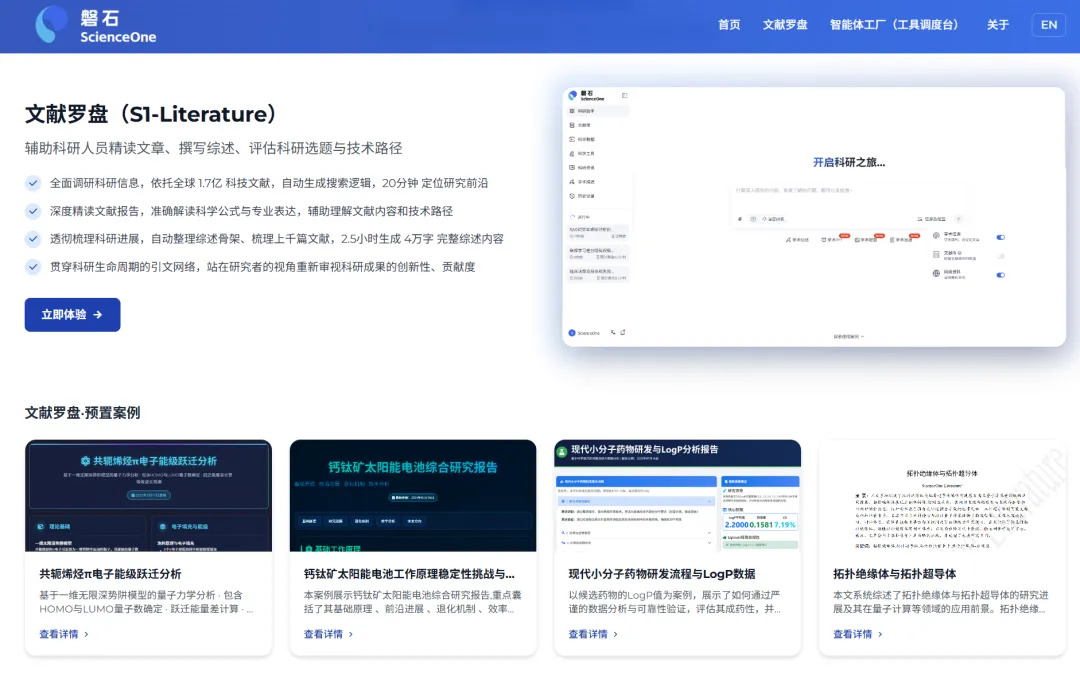
为了让这个“理科生”真正懂科研,团队用了近1.7亿篇科学论文、近1亿篇专利、1000多万个项目申请书,联合中国科学院几十个研究所,用面向不同科学任务的长思维链数据进行训练。
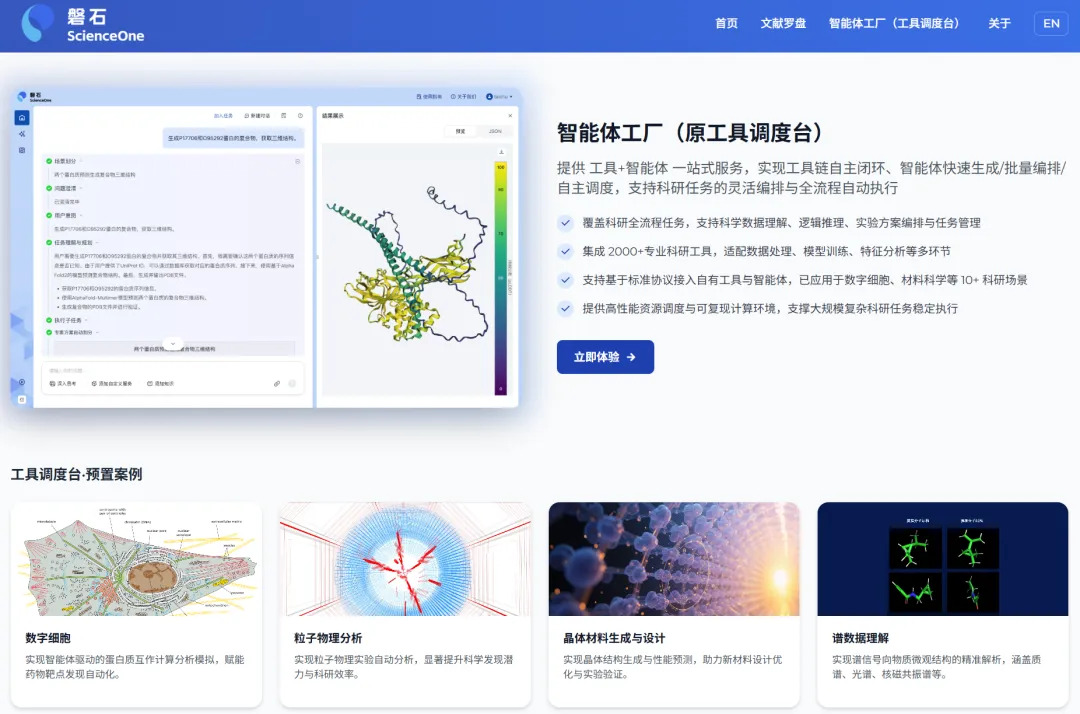
现在,磐石已经在天文观测领域大显身手。天文望远镜每天产生大量光谱数据,过去常是先存硬盘、科学家再慢慢调出来分析,通用模型看光谱却不知道频率和谱型意味着什么。磐石把对光谱的理解能力以工具形式放进郭守敬望远镜采集平台后,观测到的天文谱数据可以做实时分析,发现感兴趣事件就能及时预警,还能协同其他望远镜细看。科研从“事后分析”变成“实时跟踪”。
材料研发的变化更直观。过去做耐高温合金材料,科研人员要查文献、提方案、做样品、测试、再迭代,一轮轮下来半年可能就过去了。现在把“1000摄氏度、上万小时”的需求交给磐石材料设计智能体,它会扫描文献和专利数据库,提出候选材料,再从量子力学层面计算性能、反复改进,最后只保留3到5个高潜力方案进行实验室验证。原本需数月的设计周期被压缩到30分钟,材料研发从“经验试错”向“AI驱动”已经迈出关键一步。
“更关键的是门槛降了。全量模型动辄千亿、万亿参数,需要多台高性能AI服务器,一般硬件设备投入就上千万,很多课题组根本用不起。磐石推出轻量化设计,提供8B 、32B这种小参数量的版本,并可以根据需求定制学科能力,有些老师甚至用消费级显卡在笔记本上就运行起来了。”李林静研究员介绍。
目前磐石科学基础大模型云平台已有3000多家单位使用。从依赖国外通用模型,转向“国产科学基础底座+轻量化智能体+开源生态”。磐石正在把“AI for Science”从一句口号变成科研人员桌面上跑得动的工具。
值得一提的是,在近期外交部发布的《人工智能能力建设普惠计划》进展报告中,磐石作为教育合作的典型案例予以展示,磐石通过“一带一路”国际科学组织联盟“科学大讲堂”项目,面向全球96家成员单位的一线科研人员开展了系列学术讲座,有效促进了跨国科研合作与能力建设。
DPA:给原子世界造“通用底座”
原子级材料模拟长期存在两难问题:算得准的,太贵、规模小;算得快的,精度又不够。“DPA的解法是让神经网络从大量量子力学数据里学会原子之间怎么交互,既接近量子力学精度,又有经典力场的速度。”北京科学智能研究院大原子模型负责人张铎说。他们要做的不是某个材料体系的“偏科小模型”,而是覆盖元素周期表、能大规模模拟、还开源开放的通用原子仿真底座。
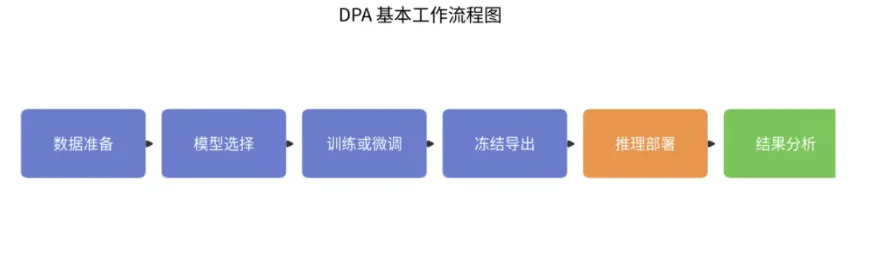
算得精、算得准,这项能力一旦落到应用场景,改变的是一条研发链路。在超导材料中,团队利用DPA从约3600万个三元氢化物空间里筛选出144种潜在高温超导体,其中120多种是第一次发现。过去靠实验一轮轮试错,现在模型先算一遍,试错成本大幅下降。
从2022年的DPA1开始,这套模型一年迭代一次。新一代大原子模型 DPA4 由北京科学智能研究院、北京大学、深势科技、北京应用物理与计算数学研究所联合研发。这个组合本身就是一条从学术源头到工程落地的完整链条。
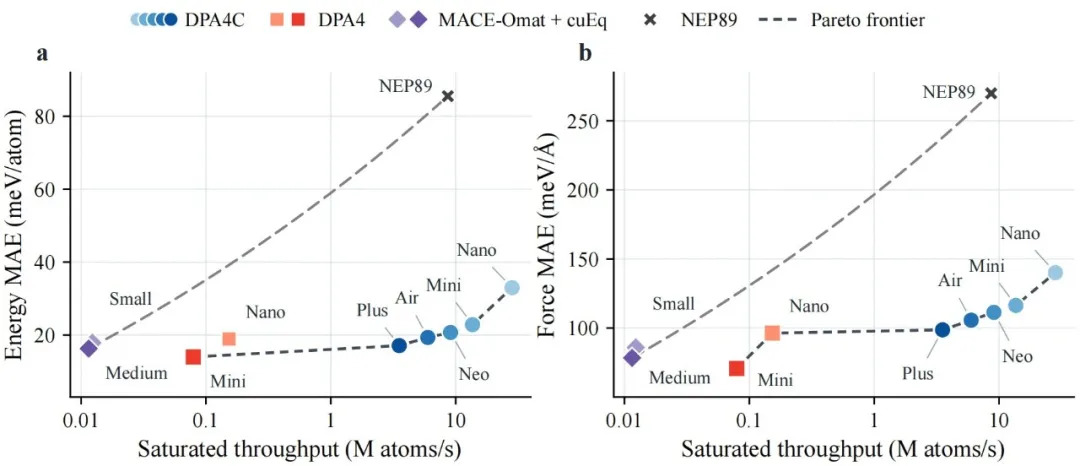
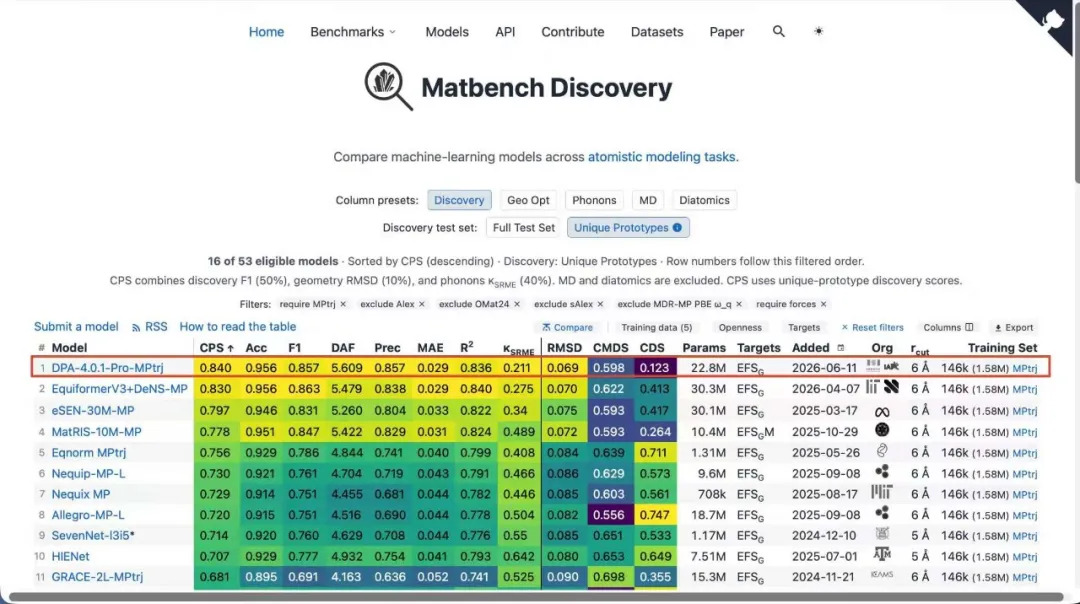
DPA4真正让人瞩目的,是它打破了“高精度必须高成本”的惯性。就像北京大学博士生李天成说的:“用极低的算力成本,达到了过去只有‘超级预算’才能触及的精度”。今年5月,DPA4在材料发现领域国际评测Matbench Discovery和小分子基准SPICE-MACE-OFF中均排名第一,综合性能领先,且训练成本较低。
未来,张铎这样展望:继续提升精度与效率,让小课题组用便宜算力也能做高精度模拟;打通干湿闭环,用实验数据回喂模型;持续建设开源开放的DeepModeling社区,推进大原子模型计划,让研究人员一键获取任意元素组合体系模型。
磐石和 DPA 面向物质世界,OpenComplex 则聚焦生命科学。它由北京智源人工智能研究院建设,突破传统AI仅能进行静态结构预测的局限,把统一图表示与扩散采样机制结合,实现蛋白质、核酸、小分子等多类型生物分子及其复合物的全原子构象分布建模。现在模型科研试用版已面向全球免费开放,注册用户覆盖国内外300余所高校和科研机构。
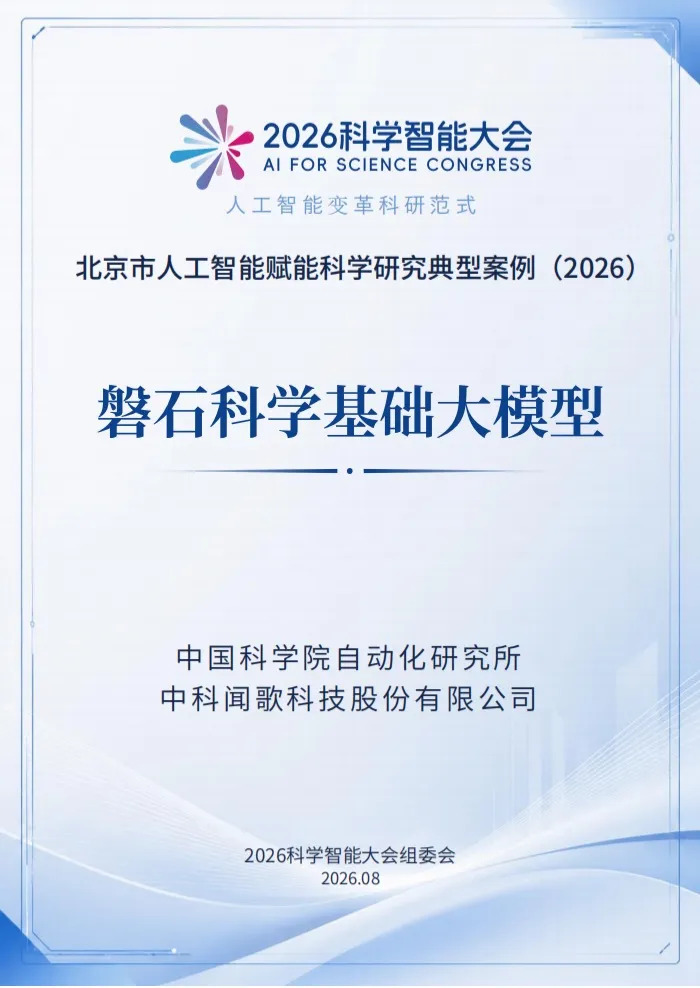
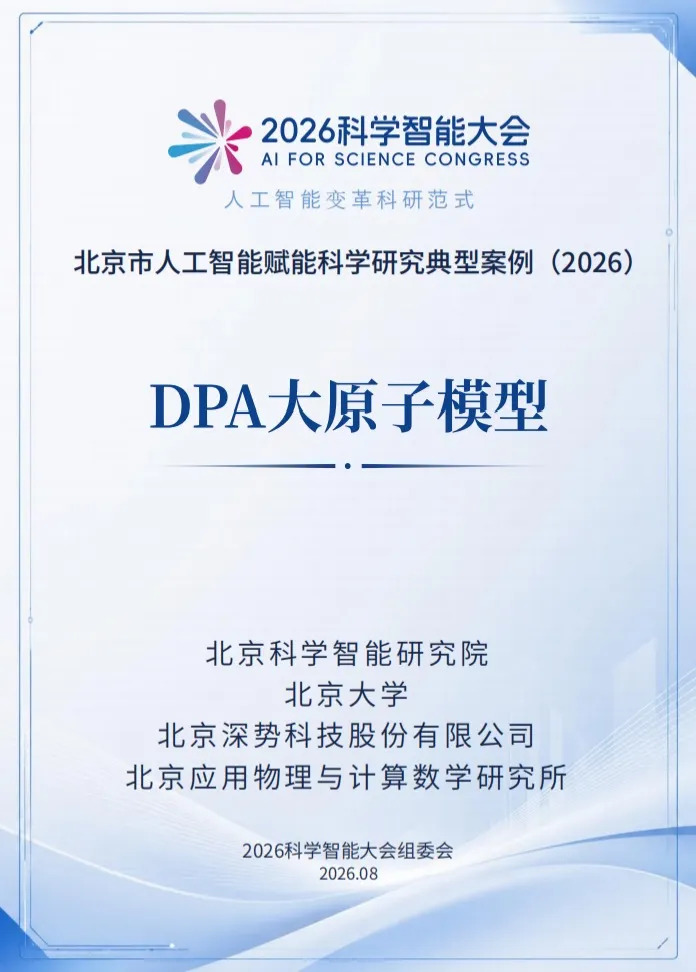
三个模型分属不同赛道,背后站着的,是北京科学智能彼此支撑的完整生态。
在李林静看来,北京顶尖高校和科研机构聚集,怀柔科学城还有大科学设施,能为训练模型提供大量科学数据,这些都是发展科学智能得天独厚的条件。张铎把训练大模型所需的支撑点说得很清楚:算力、数据、场景,缺一不可。北京先后出台科学智能专项政策和三年实施方案,把科学模型、科学数据、算力保障写进具体支持举措。在他看来,DPA能够一代代迭代,背后既有政策托举,也有真实场景的开放——模型只有看得见真问题、接受得了真检验,才能长得成熟。李天成则提到一个细节:DPA第一代就把整个元素周期表做了进去,在当时是个非常大胆的尝试。正是这种不急着索取短期回报的土壤,才容得下这样“天马行空”的想法。
在北京,科学智能已形成模型、数据、算力、场景与政策彼此咬合、协同推进的生态合力。正是这样一套完整环境,让模型不必在实验室里闭门生长,而能在真实科研的土壤里一代代迭代、走向成熟。科学智能的北京故事,才刚刚写到精彩的这一页。
科学智能北京范儿
人工智能从辅助工具跃升为推演与发现的“智能共研者”,科研范式正在发生变革。作为人工智能赋能科学研究的策源地,北京率先发布了首批16个典型案例。“科学智能北京范儿”栏目将走进这些案例,生动呈现AI参与的科学问题、改变的研究环节和取得的实际突破。邀您一起,见证智能时代科研变革的北京答案。