
研究人员辛苦跑出的实验数据,最后存在了哪里?答案是“国外平台”。长期以来,我国科研论文关联数据高度依赖国外平台,存在数据权属与访问权限不对等的风险。一旦访问受限,科研主体可能面临自有数据无法获取的困境。建设自主可控、安全开放的科研数据平台,是支撑全球科研创新的必然选择。
作为人工智能赋能科学研究的策源地,北京率先发布首批16个典型案例。在科学数据方面,科学数据银行、国家新材料大数据中心材料数据集、“敖仓”科技语料库入选。三个平台从不同环节筑牢科学智能(AI for Science,下文简称AI4S)数据底座:科学数据银行解决“数据存得住、找得到、用得上”的治理问题;国家新材料大数据中心材料数据集解决“数据从散到聚、从聚到用”的架构问题;“敖仓”科技语料库解决“数据从有到精、从精到训”的语料转化问题。
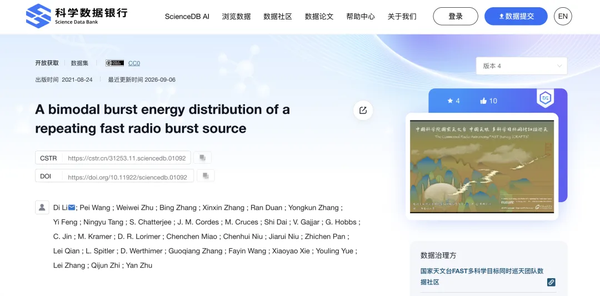
一篇论文发表了,支撑它的数据在哪?这个问题,过去很多科研人员答不上来。数据散落在硬盘里、附件里、别人的平台里,论文发了,数据却“存不住、找不到、用不上”。由中国科学院计算机网络信息中心建设运维的科学数据银行(ScienceDB),正是从这个问题切入。
故事始于2015年一本期刊。“我们办了一本期刊叫《中国科学数据》,发的不是传统论文,而是数据。”中国科学院计算机网络信息中心主任周园春回忆,数据论文背后的实体数据大的几百T、小的几兆,传统出版平台装不下,“为了做好这本期刊,我们专门搭建了配套的数据平台”。平台英文名从一开始就是Science Data Bank,后来中文定名为“科学数据银行”。“银行”二字,指向的是安全与长期可用——数据存进来,要能被稳定保存、被可信访问、被持续使用。
真正让定位发生变化的,是外部环境。国际出版商要求作者把支撑论文的数据提交到指定第三方平台,而这些平台大多在国外。周园春表示,过去很多高质量论文发表在国外,支撑数据也随之流向国外平台;原本认为全球科研共同体开放共享顾虑不多,后来发现并非如此。平台目标由此转向“打造有国际影响力的论文关联数据仓储平台”,核心是让科研人员产出的数据能够安全、可信地开放共享,同时面向全球科研共同体提供安全、可信的数据共享服务,支撑全球开放数据与科研创新。
获得国际出版商认可,是科研人员选择使用平台的核心前提。当时全球通用型存储库只有五六个,都是国外的,团队逐一对接。其中最难的是第一家Springer Nature,对方从数据描述规范性、平台服务稳定性、接口标准、功能体系、站点数据政策等维度全面核验,并对平台持续运行能力提出严格要求。历经六个月多轮修改完善,ScienceDB成为第一个进入Springer Nature推荐列表的中国通用型存储库。以此为基础,平台后续顺利通过Elsevier等出版商的认证。
进入推荐列表只是第一步。推动科研使用习惯转变还需政策引导。2021年起,中国科学院连续多年出台政策:论文关联数据优先建议存国内平台;如需存储于国外平台,须同步在国内平台备份。截至目前,平台已服务全球200余个国家和地区的科研人员获取数据,并有100多个国家的科研人员通过平台提交数据。
数据长期、安全、可信地汇聚,是重大科学突破的基础。周园春以AlphaFold为例:2024年诺贝尔化学奖授予蛋白质结构预测技术,其基础是全球科研人员几十年往蛋白质数据银行(PDB)汇交的数据。“这些数据为AlphaFold提供了关键支撑。蛋白质结构预测的突破,离不开全球科研人员长期汇交和共享的数据基础。数据对科学智能、对人工智能发展是核心资料。”这也说明,公共科研数据平台只有具备持续投入、安全访问和长期保存能力,才能为科学发现提供稳定支撑。
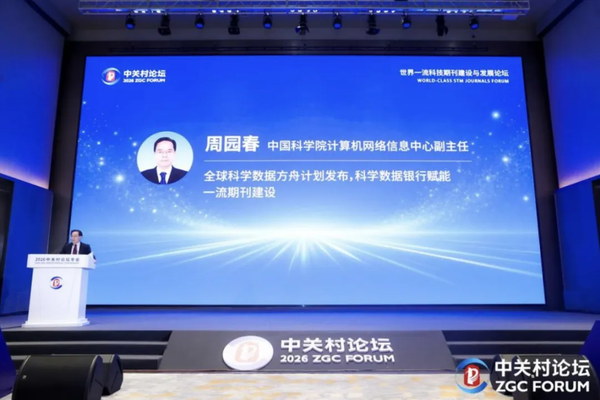
近年来,一些国家削减公共科研数据平台经费,部分政府支持的数据平台被迫关闭,全球科研数据的安全与可持续访问面临新的不确定性。这直接催生了ScienceDB的“全球科学数据方舟计划”——为全球科学数据提供永久可访问、保安全的承诺。
技术难点之外,最核心的是共享意愿。数据复制成本低、溯源难,如果贡献者得不到应有尊重,共享意愿就难以持续。ScienceDB的解法是给每个数据集一个“数字身份证”——DOI和CSTR标识,支撑确权溯源;同时由ScienceDB追踪数据在全球的引用情况,形成第三方认证。这套机制也是支撑科研人员科技成果多样化的重要部分。
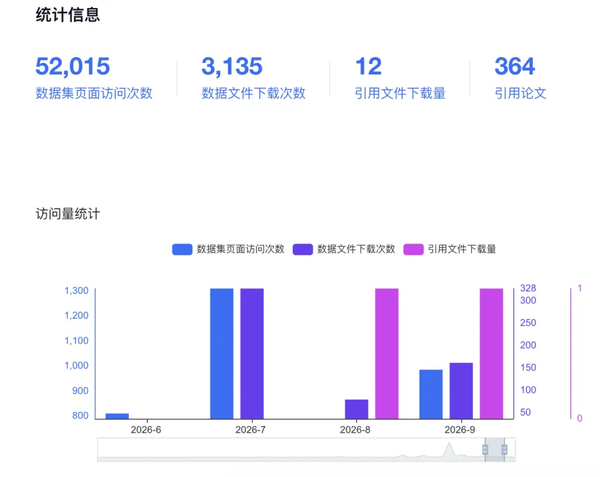
目前,平台覆盖数理、材料、生命、天文全学科,通过AI Ready技术形成标准化、可被大模型直接调用的结构化数据集,打通“科学数据存储—智能治理—模型调用”的AI4S数据链条。平台坚持公益化服务定位,以覆盖成本为原则,同时建立可持续运营机制,保障长期稳定运行,持续服务全球科研人员。
数据“存得住”“可调用”只是第一步。当数据真正汇聚起来,新的问题随之出现:格式各异、标准不一的数据,如何从“散落各处”走向“汇聚可用”?数据可用了,又该如何让科学大模型真正“理解”专业内容?
国家新材料大数据中心材料数据集回答的是前者。材料研发是AI4S最具想象空间的应用领域之一,但材料数据孤岛问题尤为突出——不同实验室、不同企业、不同软件产生的数据格式各异,质量参差,难以汇聚,更难以被AI直接利用。由北京科技大学、苏州国家实验室、北京云智材料大数据研究院等共同建设的这一平台,采用“1+N”架构——1个主平台加N个数据节点,以“物理分散、逻辑统一”原则推动材料数据资源汇聚与智能应用。中心围绕钢铁、有色金属、无机非金属、石化化工材料、纤维制品及复合材料、前沿新材料、材料综合应用7大领域,在全国建设30个数据资源节点,涵盖11大类、1400类以上材料产品,已汇聚数据规模超1亿条。
这一架构的目标很明确:让材料数据从“散落各处”走向“汇聚可用”。中心研发材料数据抽取、逆向设计、钢铁大模型等系列模型软件,打造极简在线开发平台和材料可信数据空间,通过统一门户服务新材料研发和产业创新。相关数据与技术已应用于航空航天、深海深地等场景的材料研发实践,支撑材料研发从“炒菜式试错”走向“精准计算”。
“敖仓”科技语料库回答的则是“理解”这一层。科学大模型的能力,很大程度上取决于训练语料的质量。但国内科学大模型训练长期依赖海外开源英文语料,缺少覆盖全学科、可循证、高精度的中文专业科技训练数据;通用文本语料缺少实验参数、制备工艺、分子性能等细粒度结构化知识,导致科学模型专业幻觉严重、推理可信度不足。
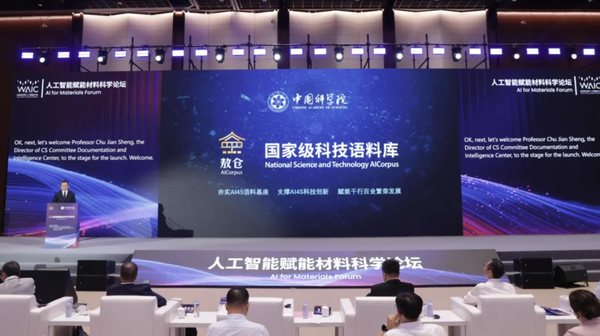
由中国科学院文献情报中心建设的“敖仓”科技语料库,以“共建、共治、共享”为理念,建设集语料汇聚、规范加工、质量测评、可信分级、应用供给和安全治理全链条的国家级科技语料基础设施。针对AI4S大模型训练需求,“敖仓”开发三阶知识精炼技术,自动提取实验参数、工艺条件、分子性能、生物靶点等细粒度结构化知识,从源头降低科学模型专业推理误差。目前已为磐石·科学基础大模型、科大讯飞科研大模型、智能化工大模型等多款国产科学基础模型提供核心训练语料支撑,并面向全国科研院所、AI企业开放材料、生命、能源等分领域语料调用服务,填补国内全学科自主可控科技训练数据供给空白。
三个平台,三种角色,构成一条完整的数据链条:科学数据银行解决“存与共享”的治理问题,让数据有归处;国家新材料大数据中心材料数据集解决“聚与用”的架构问题,让材料数据从孤岛走向可用;“敖仓”科技语料库解决“精与训”的语料转化问题,让数据真正能被大模型消化。它们共同指向一个判断:AI4S的竞争,不只是模型和算力的竞争,更是数据基础设施的竞争。
数据底座筑牢,模型才能获得充足的“营养”,算法才能有“好米下炊”。模型可以迭代,算力可以扩容,但高质量、标准化、可共享的科学数据,需要长期积累和系统治理。谁先把数据底座筑牢,谁就为科学发现准备了更丰厚的土壤。当科学数据能够规范汇交、跨域共享、高质量供给,更多科研主体就能在同一片数据沃土上训练模型、验证假设、做出发现,AI4S也才能真正从少数团队的探索走向更广泛的协同创新。北京在科学数据层面的布局,正是着眼于这一基础性工程——把数据底座筑牢,把创新土壤培厚,让科学智能走得更稳、更远。
科学智能北京范儿
人工智能从辅助工具跃升为推演与发现的“智能共研者”,科研范式正在发生变革。作为人工智能赋能科学研究的策源地,北京率先发布了首批16个典型案例。“科学智能北京范儿”栏目将走进这些第一现场,生动呈现AI参与的科学问题、改变的研究环节和取得的实际突破。邀您一起,见证智能时代科研变革的北京答案。